Data 言語資源
言語処理や人工知能への応用を目的として、様々な言語資源を構築しています。 以下に簡単な紹介と詳細ページへのリンクを掲載します。 配布版は最新でないこともあります。 最新版を入手したい場合やデータ作成にご協力頂ける場合は、著者にご連絡頂ければ幸いです。
単語係り受けコーパス
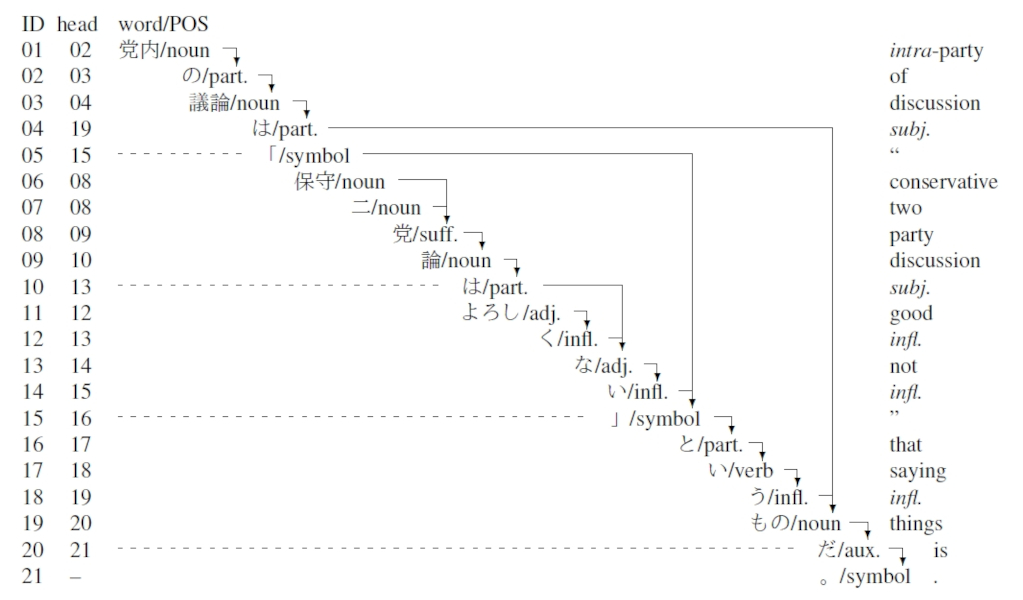
日本語の係り受けコーパスを作成・公開しています。単位は、多くの言語で標準となっている単語としています。現在、ブログなどを含む様々な文章に対して約35,000文のアノテーションがあります。付与されいてる情報は以下の通りです。
単語分割
品詞
読み(発音)
単語係り受け

このデータで学習した係り受け解析機 EDAも公開しています。
手順書のフローグラフ
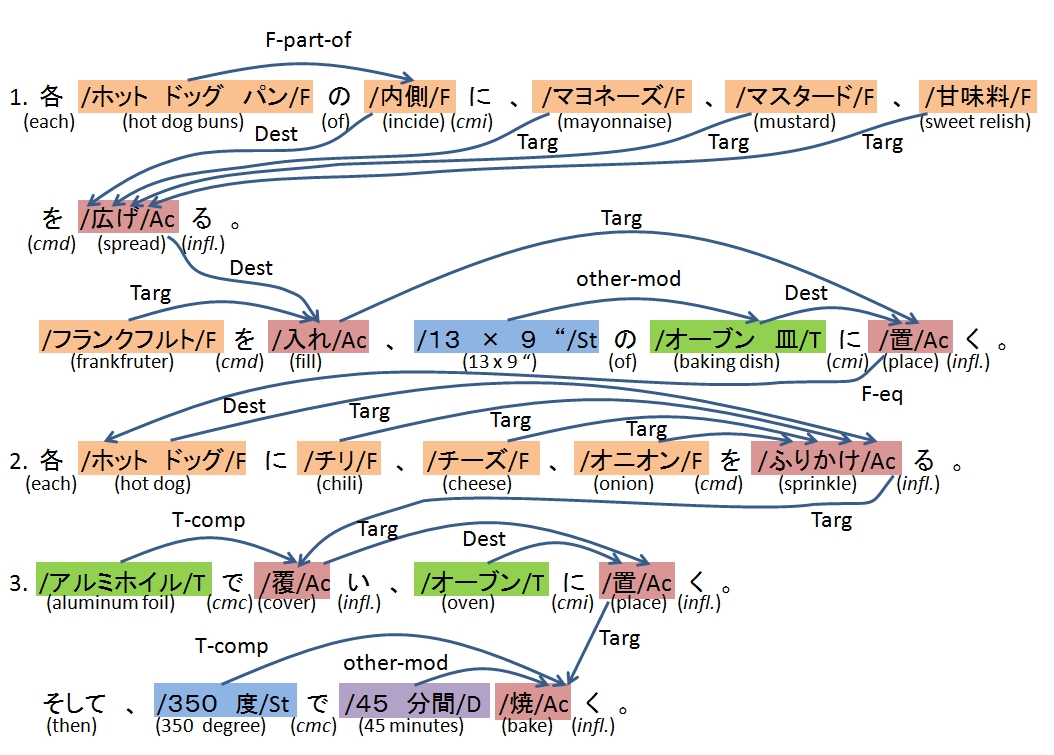
手順書の意味をフローグラフ(非巡回有向グラフ)で表現することを提案しました。手順書の代表としてサイトや書籍が最も豊富なレシピを採用しました。8種類の重要語を定義し、その関係を非巡回有向グラフ(DAG)で表現します。実際にレシピに以下のアノテーションを行い、公開しています。
用語 (8種類; 食材, 道具, 調理動作, ...)
フローグラフ

なお、食材をパーツに置き換えることで、一般の手順書に対応できます。ご興味のある方はリンクから詳細をご覧ください。

このデータで学習した固有表現認識器 PWNERも公開しています。また、フローグラフ生成ツールも構築中です。
ゲーム解説コーパス
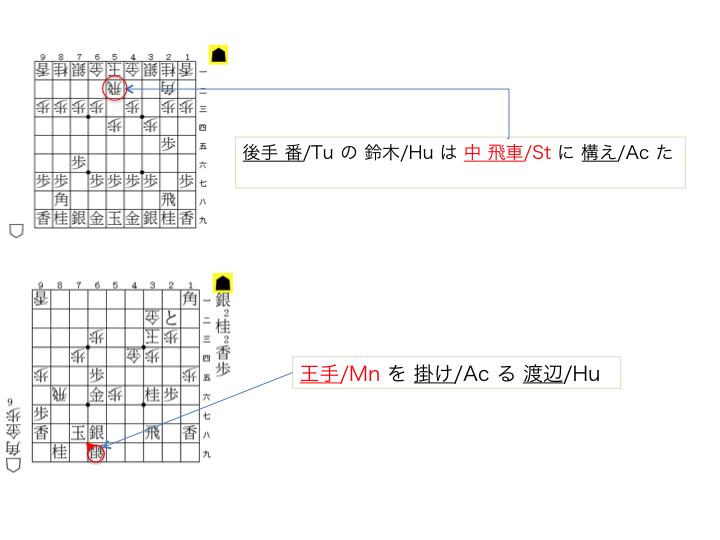
将棋の盤面とそれに対応する解説からなるコーパスです。解説の文は、単語分割に分割され、将棋用語タグが付与されています。将棋用語は、独自に定義した21種類です。
盤面(駒の配置, 持ち駒)
単語列
将棋用語

さらに、モダリティ表現のアノテーションも行いました。モダリティ表現は、否定や推量、仮定などの情報発信者の態度の表出であり、実世界(盤面)を参照しつつモダリティ表現を解析する研究の題材となります。

このデータを反映した形態素解析器(単語分割、品詞推定、読み推定)KyTea とPWNER と自動用語認識器を配布しています。

モダリティー解析モデルは現在構築中です。

Japanese Wikification Corpora
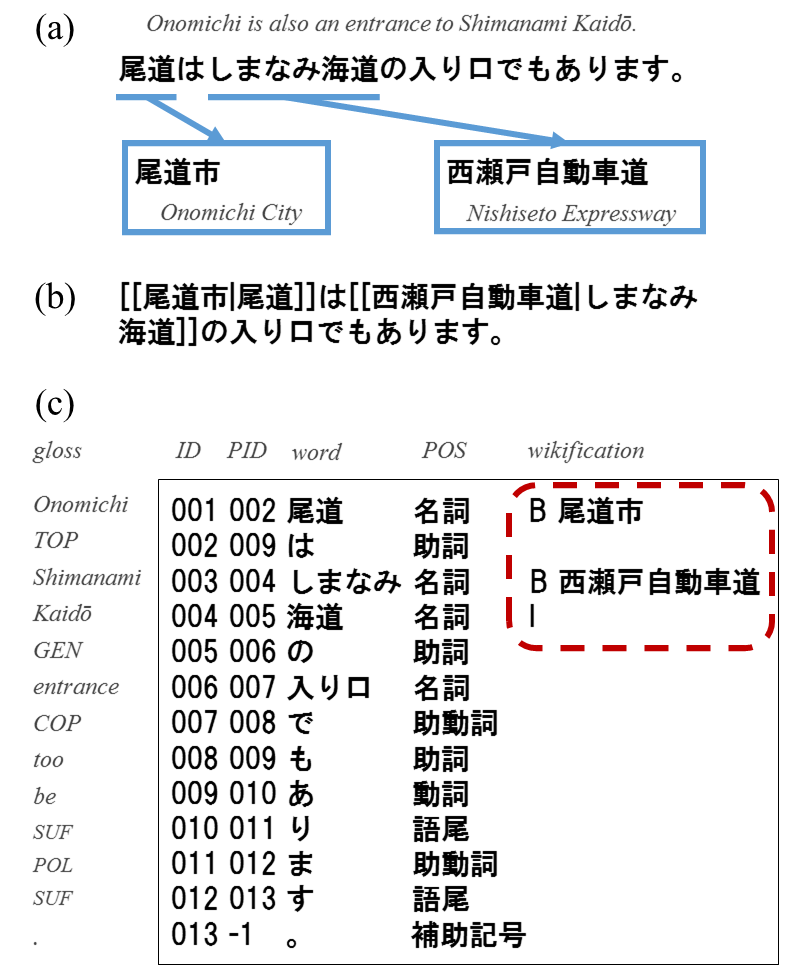
テキストを外部知識と関連づける Wikification のためのコーパスです。BCCWJ に加えて Twitter のテキストに対してもアノテーションしています。より多様なテキストに対する Wikification の研究に役立つと考えられます。
固有表現にとどまらない様々なトピック
重要な概念のみならず網羅的なアノテーション
すべてのエンティティ−は Wikipedia の記事にリンクされている

これを用いた Wikification のツールも開発中です。

京都大学大学院情報学研究科の村脇有吾先生との共同研究です。
KUSK Dataset (Kyoto Univ. Smart Kitchen Dataset)
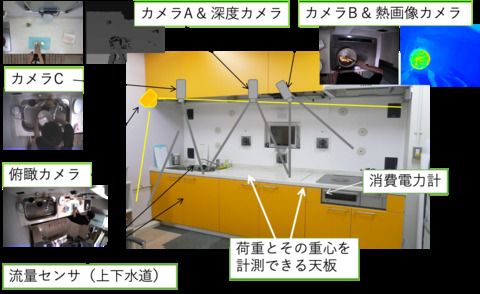
手順書に従って行われる作業の一つである調理作業の様子を多様な観測装置を備えたキッチンにより記録したマルチモーダルデータセットです。映像を中心として、サーモカメラや荷重センサ、電力センサ(IHコンロ)、上下水道の流量センサなどのデータがあります。対象となるレシピは手順書のフローグラフに含まれる20種類となっています(対応表)。
UniDic++(仮)
形態素解析器(単語分割・品詞推定)のための追加の辞書です。特許や医療、レシピなどのさまざまな分野のテキストから単語を収集しています。多くの単語には文脈情報も付いているので、形態素解析精度の向上により有効です。
KyTea の強化
単語/品詞/読み
出現文脈

なお、食材をパーツに置き換えることで、一般の手順書に対応できます。ご興味のある方は詳細をご覧ください。

このデータを反映した形態素解析器(単語分割、品詞推定、読み推定)KyTea を配布しています。

WikiText-JA

「質の良い」日本語テキストコーパスとして、日本語版Wikipediaにおいて「秀逸な記事」および「良質な記事」と認定されている記事を収集したコーパスです。
前処理としてのデータクレンジングも事前に施しています。

本プロジェクトは The wikitext long term dependency language modeling dataset を参考に実施されました。

WHLL: Wikipedia Hyperlink-based Location Linking

Wikipedia記事に付与された緯度経度情報とハイパーリンク情報を利用して、記事中の地名に対して緯度経度情報を付与したコーパスです。

BioVL: Vision & Language for Biochemistry

特に生化学に関連する手順書と一人称視点作業映像のペアに対するV & Lタスクのためのデータセットです。

その他の言語資源
方言の音声と書き起こし
Tool 自然言語処理ツール
KyTea(きゅーてぃー)
京都テキスト解析ツールキットKyTeaは、日本語など、単語(または形態素)分割を必要とする言語のための一般的なテキスト解析器です。主に以下の処理ができます。
単語分割
品詞推定
読み推定
モデル
23G (KyTea-0.4.7 同梱モデルに国立歴史民俗博物館の協力により日本史の用語を強化したモデル)
  • 通常モデル (.kbm)
  • 追加学習用 (.kff)
超短単位
KyTeaの同梱モデルは、概ね国立国語研究所の短単位です。違いは以下の通りです。
  • 活用語の語尾を分割して別単位としている
  • 語尾という品詞を追加している
この変更によって、文生成などの応用において、小さい語彙で高い被覆率を実現することができます。
例えば、動詞の「歩く」は
  • 歩か (ない)
  • 歩き (ます)
  • 歩く
  • 歩け (ば)
  • 歩け
  • 歩こ (う)
と言うように活用し、5つの表記となります。文生成システムにおいて、これら全ての表記が語彙に含まれることが望まれます。
超短単位では、これを語幹「歩」と語尾群として語彙に含めます。語尾群は、カ行五段活用の他の動詞と共通なので、カ行五段活用の他の動詞を語彙に加えるは、語幹のみを加えることで全ての活用形を被覆できます。これは他の活用型についても同じです。
一方、解析の場合には、活用語は語幹が表記となるため、少し分かりにくくなります。例えば動詞「歩く」の頻度は「歩」の頻度として集計されます。また、終止形の頻度は「歩-く」という2単位の連続(2-gram)の頻度として集計されます。
N3ER(えぬすりーえぬいーあーる)
!!Under Construction!!
用語(単語列とクラスの組)認識
PWNER の後継
ニューラルネット(Bi-LSTM)に基づくようになりました。辞書追加の機能など現在鋭意改良中です。
PWNER(ぴーだぶりゅーえぬいーあーる)
用語(単語列とクラスの組)認識
デフォルトモデルの単位は超短単位で、KyTea の出力を使うとよいでしょう。
EDA(えだ)
EDA は単語係り受け解析器です。 日本語のように左から右に行く係り受けや、英語のように左や右に行く係り受けの両方を扱えます。
係り受け解析
デフォルトモデルの単位は単語で、KyTea の出力を使うとよいでしょう。
Senn(せん)
Sennはオープンソースの IME です。Senn のかな漢字変換エンジンを研究室のリソースを使ってビルドし、パッケージしたものを公開しています。
  • パッケージ

なお、かな漢字変換エンジンのビルドにあたってはBCCWJ (国立国語研究所)のリソースを用いています。

MS-IME 用辞書
SENNの学習データから MS-IME 用辞書も生成しています。
  • 日本史用語辞書 (国立歴史民俗博物館の協力による)
CaPSL(かぷせる)
CaPSLはCRFと点予測のマルチタスク学習による系列ラベリングツールです。点予測での学習を行なうことで、部分的アノテーションによる学習を可能にしています。
PNAT(ぴーなっつ)
コーパスアノテーション
単語境界
単語の品詞・読み
固有表現タグ
単語の係り受け
Kagamine Lin, Ren(仮, かがみね りん, れん)
連語獲得
単語クラスタリング
PALIN(ぱりん)
未知語抽出 (文字列, 品詞)
固有表現 (単語列, 固有表現クラス)
X デモ
NLP技術のデモのためにXアカウントを運用しています。
レシピ言語処理マニュアル
レシピに対する言語処理ツールなど
単語分割・品詞推定・読み推定
レシピ用語(r-NE)認識
Tool 利用例
テキスト解析
文から単語の係り受け構造を推定します。
  1. KyTea (単語分割, 品詞推定)
  2. ?? (NER, optional)
  3. EDA
言語モデル作成
音声認識や仮名漢字変換の言語モデルを作成します。
  1. KyTea (単語分割, 読み推定)
  2. Kagamine (連語獲得, クラスタリング, optional)
  3. LM tool (KyLM, SRI LM, Palm Kit, ...)
単語分割・品詞推定の分野適応
対象のテキストの単語分割や品詞推定の精度が低いと感じる場合に精度向上を行います。 固有表現抽出でも同様の手順に従います。
  1. PALIN (未知語候補抽出)
  2. PNAT (コーパスの部分的アノテーション)
  3. KyTea 再学習 (単語分割, 品詞推定; 素性頻度ファイルの利用)
  4. KyTea (単語分割, 品詞推定)